冒泡.gif
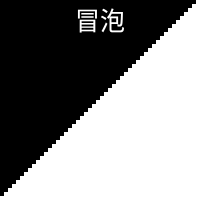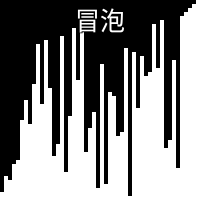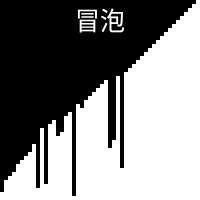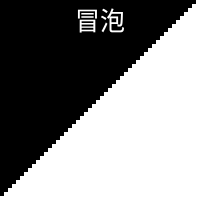
2025年12月,预防用Uiua语言制作了一个冒泡排序演示动画GIF,我为其添加文字“冒泡”后当作动画表情,这个版本被一些群友传播使用。如果你见过这个动画表情,也许你我是有点缘分在的。而现在,我重新编写代码重制了这个动图。
起因是群友最近提起这个动画表情的历史,让我发现了旧版冒泡动图的打乱算法不是等概率的:
50个数,它随机选取两个索引(可能相同),交换对应位置的两个数,这样随机交换50次。如果个数像这样随机交换次,可以算出,一个数在打乱结束后仍在其初始位置的概率为
对于即
而如果是真正的随机打乱,每个数落在每个位置上的概率应该都是
随着随机交换的次数增加,每个数最后仍在初始位置的概率收敛越来越慢:计算发现,至少需要随机交换169次,这个概率才能小于0.021,非常不划算。
于是,我决定使用原地Fisher-Yates洗牌算法重制这个动图:每次随机抽一个数,调换至末尾视为已经从牌堆拿出,再从其余的数里再抽,直到抽完;同样50步,做到等概率打乱。
为了稳定结果,我使用了固定的随机种子42来生成打乱步骤(将 42 换成 ⚂random 即可随机种子):
50 42
⊃⊃gen⇡₁⇡
#### [0 1 2 3 4 5 6 7 8 9 10 11 12 13 14 ⋯ 49]
#### [1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 ⋯ 50]
#### [0.5750270253589709 0.017827759325609538 0.9605669352631439 ⋯]
两个 ⊃fork 让三个函数共用参数:gen 50 42 返回50个0–1的随机数,⇡₁ 50、⇡ 50 分别返回1–50和0–49的整数数组。
⊃(⇌⍉⊟ ⌊×)⋅∘
### [1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 ⋯ 50]
### ╭─
### ╷  7 49
###   34 48
###   14 47
###   ⋮⋮ ⋮⋮
###    0  2
###    0  1
###    0  0
###         ╯
⌊× 让随机数跟1–50相乘再向下取整,得到的随机数各一个;⇌⍉⊟ 将其跟0–49组合,转置后倒序,得到打乱各步要交换的索引对。同时,⊃fork 的另一支 ⋅∘ 将1–50数组保留,稍后当作打乱和排序的数据使用。
⊸⊣ ∧⊸⍜⊏⇌
### ╭─
### ╷  1  2  3  4 5  6  7  8 9 10 11 12 13 14 15 ⋯ 48 49 50
###    1  2  3  4 5  6  7 50 9 10 11 12 13 14 15 ⋯ 48 49  8
###    1  2  3  4 5  6  7 50 9 10 11 12 13 14 15 ⋯ 48 35  8
###    1  2  3  4 5  6  7 50 9 10 11 12 13 14 48 ⋯ 15 35  8
###    ⋮  ⋮  ⋮  ⋮ ⋮  ⋮  ⋮ ⋮⋮ ⋮ ⋮⋮ ⋮⋮ ⋮⋮ ⋮⋮ ⋮⋮ ⋮⋮ ⋱ ⋮⋮ ⋮⋮  ⋮
###   46 39  6 10 9 25  2 20 5 40 44 29 43 19 41 ⋯ 15 35  8
###                                                         ╯
### [46 39 6 10 9 25 2 20 5 40 44 29 43 19 41 ⋯ 15 35 8]
∧fold 将1–50作为初始值,对每个索引对执行 ⍜⊏⇌ 交换相应位置的两个数据,同时⊸by 保留交换前的整个数组状态,由 ∧fold 收集并输出为二维数组,记录下数据打乱的全过程。然后,使用 ⊸⊣ 复制二维数组的最后一行,也就是打乱完成后的数组。
这里,由于第50次抽取是从最后仅剩的1项里抽取1项,最后一个要交换的索引对必定是
[0 0],相当于没有交换,所以我直接使用每次交换前的状态来构建打乱过程,而不是交换后的。如果打乱的最后一步是有用的,可以仿照下面构建排序过程的写法,写∧(⟜∘ ⍜⊏⇌)来复制交换后的状态;这样也会导致动画的第一帧显示的是第一次交换后的状态,而非完全有序的数组——旧版的冒泡.gif就是这样。
接下来,我预先构建了冒泡排序每步需要比较的索引对——这一步的代码写出来跟预防的原版基本上一模一样:
/◇⊂ ⇌⧅⌞□ ⧈⊟°⊏
## ╭─
## ╷  0  1
##    1  2
##    2  3
##    ⋮  ⋮
##   48 49
##    0  1
##    1  2
##    ⋮  ⋮
##   47 48
##    0  1
##    1  2
##    ⋮  ⋮
##    2  3
##    0  1
##    1  2
##    0  1
##         ╯
°⊏ 获取上面打乱后数组的所有索引(0–49),⧈⊟ 将其中所有相邻的两项成对。⧅⌞□ 列出所得数组的所有前缀(ABCD → {A AB ABC ABCD}),⇌reverse 倒序后({ABCD ABC AB A}),/◇⊂ 将其连在一起(ABCDABCABA)。
随后就是照着这些索引,对乱序数组进行排序,并记录过程:
∧(⟜∘ ⍜⊏⍆)
## ╭─
##   1225×50 ℝ
##   1-50 μ25.5
##              ╯
同样用 ∧fold 将乱序数组作为初始值,对每个要比较的索引对执行 ⍜⊏⍆,即把这两个索引上的数据按大小调整位置,然后 ⟜∘ 复制调整后的整个数组,作为排序过程的记录。排序过程较长,我们跟预防的原版一样加速4倍:
⍜⊙⇌▽1/4
## ╭─
##    306×50 ℝ
##   1-50 μ25.5
##              ╯
我们在 ⇌reverse 倒序的情况下 ▽1/4 保留四分之一的行,再倒序回去,倒序是为了确保最后一行数据——也就是排序完成后的有序数组——被保留,否则如果最后几步中存在交换就会出问题。
现在打乱和排序的过程都准备好了,我们将其连接成完整的时间轴:
˜⊂ ∩⌞⍜⊙⊣↯21
## ╭─
##    396×50 ℝ
##   1-50 μ25.5
##              ╯
∩both 带方向下标,保留左侧一个共同参数 21 对两个二维数组分别执行 ⍜⊙⊣↯ 将最后一行重复21次(预防原版是额外增加静止的20帧,这里保持总帧数一致)。然后 ˜⊂ 将二者反向连接(先是打乱过程,然后排序过程)。
最后把每一帧的数组状态呈现为二维的条形图,这里我基本照搬了预防的代码:
≡▽₂4 ≡⌞⊞> ⇌⇡⊸⧻₁
&gifs50
图片顶部记为50,底部记为1。⇌⇡⊸⧻₁ 生成50–1的数组,≡⌞⊞> 把每列每个大于当前列数值的像素填为白色(1),其他为黑色(0)。≡▽₂4 跳过时间轴,把横、纵轴放大4倍。最后,使用 &gifs50 以每秒50帧输出为GIF(预防原版是48,但GIF没那么精确,实际输出就是每秒50帧)。
至此,动画本身就完成了,而为了添加文字,我借助LNNBot,使用跟之前制作旧版动画表情时相同的参数生成了透明底的文字叠加层:
<| textoverlay -b start -s 20 冒泡 | color -s 200 transparent

使用这张图片作为输入(Uiua网页端或原生环境在代码开头使用 &frab 读取二进制文件,LNNBot直接引用图片调用 uiua 指令),在 &gifs50 前面加一行:
+× ⊙(∩¤ ¬⤙× ⧋(÷⧻⟜/+°⊂⌟) ◌°img)
基本上就是解码图片字节数据得到叠加层RGBA,用叠加层的RGB求平均作为亮度,叠加层的亮度乘以Alpha,再用动图的亮度乘以叠加层Alpha的反相,二者相加得到最终亮度。